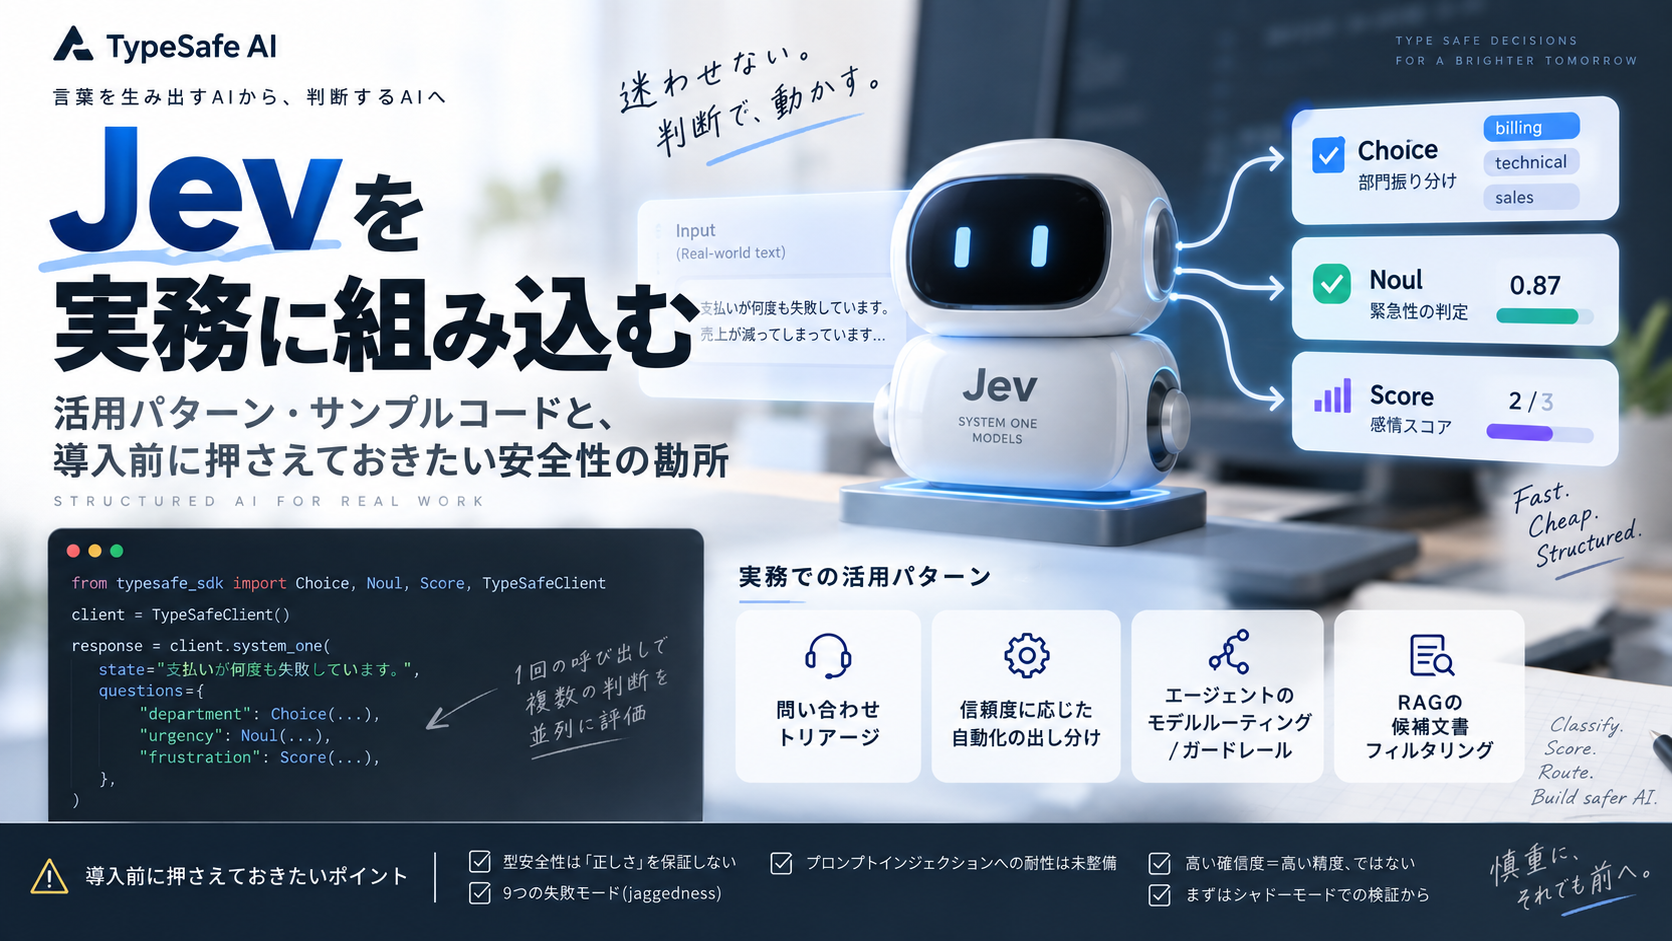
前回の記事では、TypeSafe AIが発表した「チャットしないAI」ことSystem One Models/Jevの概要と、公表された数字の割り引いて見るべきポイントを整理しました。今回はもう一歩踏み込んで、実際にコードを書くとどう使うのか、どんな業務に当てはめられそうか、そして実務に取り込む前提で見たときに何に気をつけるべきかを、公開されているドキュメントやSDK、第三者による解説記事をもとに整理します。
なお本記事で紹介するコードやユースケースは、TypeSafe AI公式ドキュメント、LangChainやCloudflareなどのインテグレーション解説、開発者コミュニティの解説記事(参考情報を参照)をもとに再構成したものです。Jev自体が早期アクセス段階のプロダクトであり、仕様は変更される可能性があること、また第三者による独立した検証がまだ十分になされていないことは前回同様に留意してください。
おさらい:Jevは「会話」ではなく「判定」を返すモデル
Jevは自由形式の文章を生成する代わりに、あらかじめ定義した質問(Choice=選択、Score=採点、Noul=真偽判定)に対して、キャリブレーションされた確率つきの答えを高速(70〜500ミリ秒)かつ低コスト(入力100万トークンあたり0.042ドル、出力は無料)で返すモデルです。詳しい背景は前回の記事をご参照ください。
環境を用意する
SDKはPython・Node.js双方が提供されています。
pip install typesafe-sdk        # Python 3.10+
npm install @typesafe-ai/sdk    # Node 20+
APIキーは環境変数TYPESAFE_API_KEYに設定しておけば、クライアント初期化時に自動で読み込まれます。
基本の書き方:3つのプリミティブ
Choice・Score・Noulはいずれも「1つの質問には1つの明確な判断だけを問う」ことが設計上の原則とされています。複数の独立した判断が必要な場合は、質問を分けて並列に投げ、結果をコード側で結合するのが推奨パターンです。
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()

response = client.system_one(
    state="支払いが何度も失敗しています。売上が減ってしまっています…",
    questions={
        "department": Choice(
            instructions="どのチームが対応すべきか",
            criteria={
                "billing": "支払い・サブスクリプションの問題",
                "technical": "バグやシステム連携の不具合",
                "sales": "料金プランやアカウントに関する質問",
            },
        ),
        "urgency": Noul(
            instructions="このメッセージは緊急性を示しているか",
        ),
        "frustration": Score(
            instructions="この顧客はどの程度苛立っているか",
            criteria=["落ち着いている", "苛立っている", "非常に怒っている"],
        ),
    },
)

dept = response.answers["department"].choice
urgency = response.answers["urgency"].noul       # 0.0〜1.0の確率
frustration = response.answers["frustration"].score
1回の呼び出しで3つの質問を並列評価し、部門振り分け・緊急度・感情スコアをまとめて取得できる点が、逐次的にLLMへ質問を投げる従来のやり方との大きな違いです。
実務での活用パターン
パターン1:問い合わせのトリアージ
上のコードそのものが典型例です。サポートチケットや問い合わせフォームの本文をstateに渡し、部門振り分け・緊急度・感情スコアを同時に判定してルーティングします。ヘルプデスクツールとの連携や、Slack通知の優先度付けなどに応用しやすいパターンです。
パターン2:信頼度に応じて自動化の度合いを出し分ける
Jevの出力は確率(確信度)つきで返るため、確信度に応じてアクションを段階的に変える「信頼度ゲーティング」がよく紹介される設計パターンです。
if urgency >= 0.9:
    action = "auto_escalate"     # 自動でエスカレーション
elif urgency >= 0.5:
    action = "propose_to_human"  # 提案は出すが人が確認・実行
else:
    action = "queue_normal"      # 通常キューに積むだけ
閾値(0.9/0.5など)はあくまで一例で、「ドメインとキャリブレーション結果に基づいて調整が必要」と複数の解説記事が強調しています。閾値を固定値で決め打ちせず、後述するシャドーモードでの検証を経てチューニングすることが前提です。
パターン3:LLMエージェントのモデルルーティング/ガードレール
LangChainはJevを使ったミドルウェアを公開しています。1つは「タスクの難易度に応じて安価なモデルと高性能なモデルを出し分けるルーター」、もう1つは「危険なツール呼び出しを実行前にブロックするガードレール」です。
from langchain.agents import create_agent
from langchain_typesafe.experimental.middleware import (
    ModelChoice,
    ModelRouterMiddleware,
    AutoModeMiddleware,
)

router = ModelRouterMiddleware(
    choices={
        "fast": ModelChoice(model="openai:luna", criteria="単純な参照・抽出・局所的な修正"),
        "powerful": ModelChoice(model="openai:sol", criteria="設計判断や影響範囲の大きい変更"),
    },
    instructions="タスクを完了できる中で最もコストの低いモデルを選ぶ",
)

guardrail = AutoModeMiddleware(tools=["bash"])  # 危険な操作をツール実行前にブロック

agent = create_agent("openai:gpt-5.6-luna", middleware=[router, guardrail])
エージェントに「何でも実行させる」のではなく、実行直前にJevで危険度を判定してブロックするという発想は、生成AIエージェントの安全性を語るうえでも参考になる設計です。
パターン4:RAGの候補文書フィルタリング
検索で引っ張ってきた文書断片や引用元候補を、Choiceで「本当に関連しているか」、Scoreで「根拠としての強さ」を判定してから生成モデルに渡す、というパターンも紹介されています。生成LLMに渡す前段のフィルタとして使うことで、コンテキストの無駄打ちや誤った引用を減らす狙いです。
どこまで実際に使われ始めているか
早期アクセス段階であることもあり、社名を明かした導入事例の公開情報は今のところ見当たりませんでした。一方で、エコシステム面での動きはいくつか確認できます。CloudflareはWorkers AI経由でJevを「構造化評価モデル」として提供し、問い合わせルーティング・返金判定・アカウントのリスク評価をサンプルとして挙げています。LangChainは前述のミドルウェアを公開し、Vercel AI SDKにも実験的なevaluate関数としての統合が見られます。GitHub上にも有志によるユースケース集(awesome-jev系のリポジトリ)が複数公開されており、スターターコードやオフラインテストの型がまとまりつつある段階です。裏を返せば、「特定企業の本番実績」という意味での事例はまだ乏しく、現状はSDK・フレームワーク統合が先行しているフェーズと見るのが実態に近そうです。
安全性・リスクの観点から見ておくべきこと
実務に取り込む前提で見ると、速度やコストの魅力とは別に、いくつか具体的に押さえておくべきリスクがあります。
型安全性は「正しさ」を保証しない。 Jevが返す答えは必ず定義済みスキーマの範囲内に収まりますが、それは「選ばれた答えが正解である」ことまでは意味しません。5つの選択肢のいずれかを返すことは保証されても、本当の正解が想定していなかった6つ目のケースだった場合には対応できない、という指摘は複数の解説記事で共通して挙げられています。
公式ドキュメントが認める9つの失敗モード(jaggedness)。 TypeSafe AI自身が「Jev 1.13の弱点」として公開している内容によれば、(1)指示文を文字通りにしか解釈できない、(2)計算・カウントが不得意、(3)日付やテキストとしての時系列比較が不正確、(4)間接的な多段推論に弱い、(5)無関係な情報が混じると精度が落ちる、(6)敵対的な入力(後述)に弱い、(7)矛盾した指示や基準に混乱する、(8)同じ判断でもNoul/Choice/Scoreなど質問形式を変えると結果が数学的に矛盾しうる、(9)テキストやコードの生成はできない、という点が挙げられています。実装時は「モデルに数学やカウントをさせない、判断だけを渡す」「指示文に境界条件を明示する」といった設計上の配慮が必須です。
プロンプトインジェクションへの耐性は未整備。 stateとして渡すテキストにモデルを誤誘導する意図的な文言が含まれるケースについて、TypeSafe AI自身が「今後の改善を見込むが現状は保護されていない」といった趣旨を明らかにしているとの解説があります。ユーザー入力やスクレイピングしたWebコンテンツをそのままstateに渡す設計は、プロンプトインジェクションのリスクをそのまま抱え込むことになるため、入力のサニタイズや、重要な判断ほど人間のレビューを挟む設計が推奨されます。
高い確信度=高い精度、ではない。 キャリブレーションを訓練目標にしているとはいえ、それはあくまで「その確信度を割り当てた集団全体で見たときの的中率」の話であり、個々の判定が高確信度でも外れることはあり得ます。1つの選択肢が突出して選ばれている(確信度が高い)ことと、その選択が正解であることは別問題だという整理です。
公開されている数字は未検証。 ベンチマークの数値やコスト削減効果はすべてTypeSafe AI自身の発表によるもので、第三者による独立検証や、社名を伴う顧客実績の開示は今のところ確認できません。価格体系も早期アクセス段階のものであり、将来変更され得る旨が明記されています。
実務導入までの進め方(たたき台)
以上を踏まえると、実務導入に向けては次のような段階を踏むのが現実的な進め方として複数の解説記事で共通して推奨されています。
- ラベル付きデータセットを用意し、想定する質問設計(Choice/Score/Nounの基準文言)で事前に精度を評価する。
- 既存システムと並行して動かす「シャドーモード」を一定期間(目安として1週間以上)設け、実運用データでの的中率と確信度のキャリブレーションを検証する。
- 自動化はリスクの低い経路から始め、確信度が低いケースや影響の大きい判断は人間のレビューに回す設計にする。
- 数値計算・日付比較・カウントなどJevが不得意な処理はコード側で行い、Jevには「判断」そのものだけを渡す。
stateに外部由来のテキストを含める場合は、プロンプトインジェクションを前提に入力を検証・制限する。- 導入後も、表明された確信度と実際の的中率のズレ(キャリブレーションのドリフト)を継続的にモニタリングする。
まとめ
Jevは、分類・ルーティング・スコアリングといった「型の決まった判断」を大量にさばく用途において、速度とコストの両面で魅力的な選択肢になり得るモデルです。SDKも整っており、既存のエージェントフレームワークやサーバーレス基盤への統合も進みつつあります。一方で、型安全性はあくまで出力の「形」を保証するものであり「正しさ」を保証するものではないこと、プロンプトインジェクションへの耐性が現状十分でないこと、そして具体的な弱点(jaggedness)が公式に列挙されていることは、実務に取り込む前提で見たときに軽視できないポイントです。速さと安さに飛びつく前に、ラベル付きデータでの事前評価とシャドーモードでの検証を経て、確信度が低いケースを人間に戻す設計を組み込んだうえで、段階的に自動化範囲を広げていくのが現実的なアプローチと言えそうです。
本記事は、TypeSafe AI公式ドキュメントおよび各種開発者向け解説記事(2026年9月時点の情報)をもとに、サンプルコードとユースケースを一般向けに再構成したものです。コードは動作を保証するものではなく、実際の導入にあたっては必ず公式ドキュメントと最新のSDKを確認してください。数値・主張の多くはTypeSafe AI自身または第三者ブログの発表に基づくものであり、独立した検証がなされたものではない点にご留意ください。
参考情報
- Introduction – TypeSafe AI Docs
- Jev 1.13 jaggedness – TypeSafe AI Docs
- How to Use Jev: A practical guide to TypeSafe’s System One model – DEV Community
- What Is Jev? How to Implement Typesafe AI’s Decision Model (Practical Guide) – Mohammed Shehu
- What Is Jev? A Guide to TypeSafe AI’s System One Model – LangChain Blog
- A deep dive into Jev, TypeSafe’s System One model – Flavio Copes
- Jev (typesafe) – Cloudflare AI Docs
- TypeSafe’s Jev and the Parse-Validate-Retry Tax – FourWeekMBA
- awesome-jev-by-typesafe – GitHub
- awesome-jev – GitHub