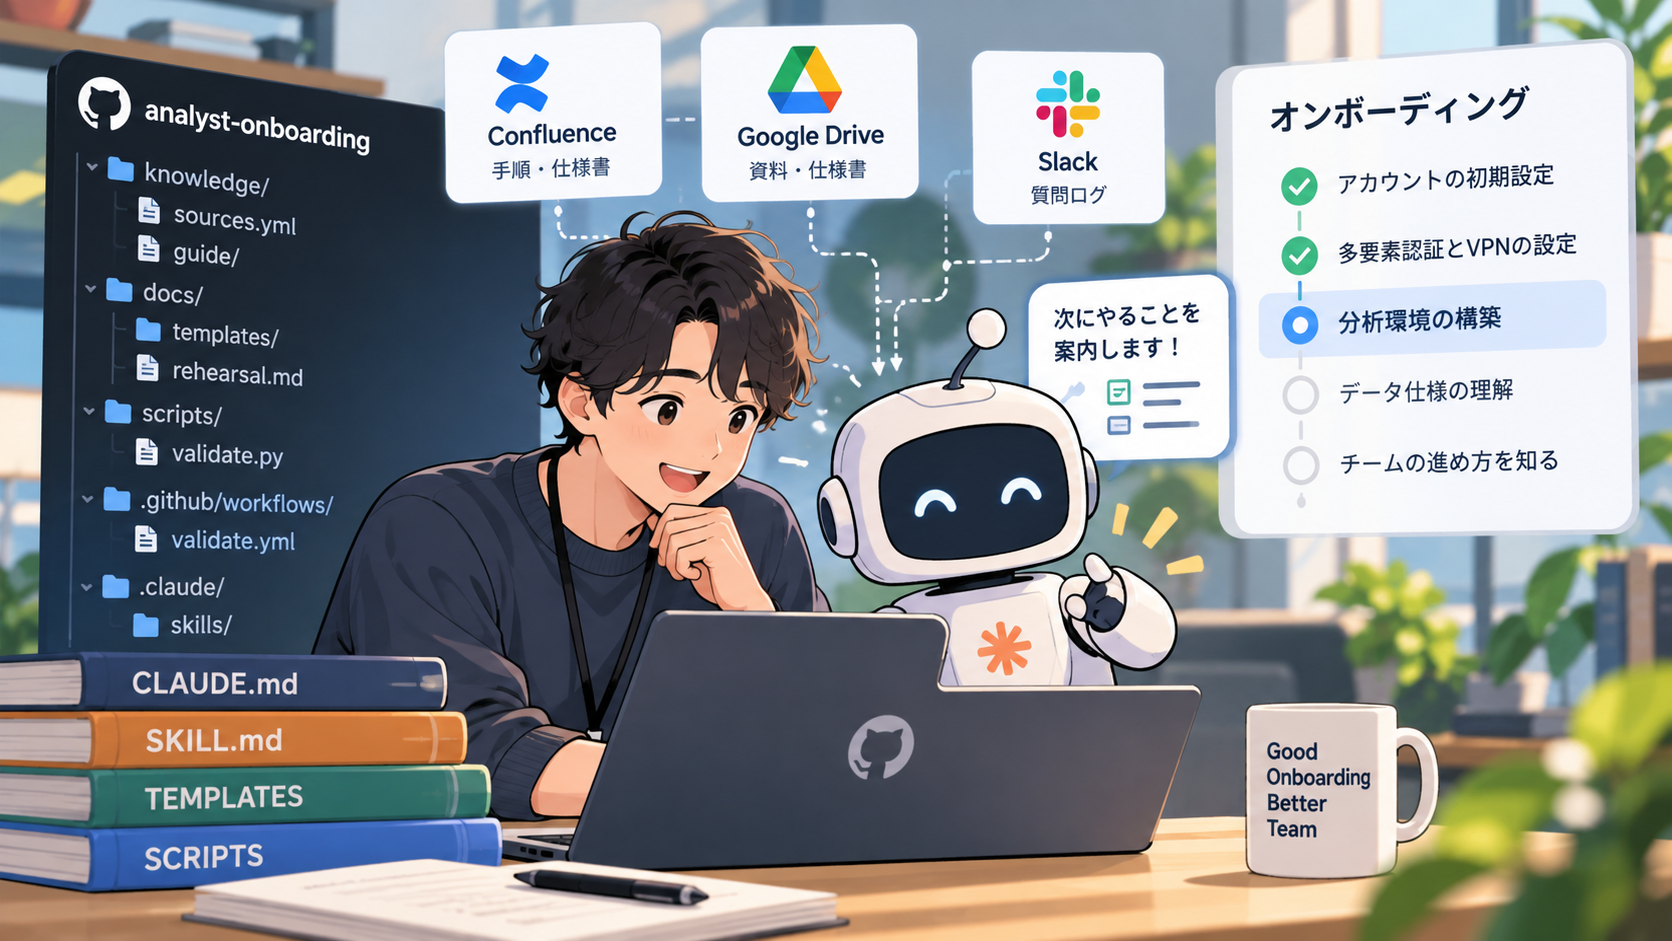
2026年10月、DeNAのエンジニアリングブログに「オンボーディングをAIエージェントに任せたら、もはや別ゲーだった」という記事が公開されました。データサイエンス部のオンボーディングを1つのGitHubリポジトリに集約し、Claude Codeを新規メンバーに伴走させた取り組みで、中途入社のメンバーが約1か月でオンボーディングを完了したという実践レポートです。
記事では設計の考え方や運用で見えた落とし穴が丁寧に語られていますが、リポジトリの中身そのものは公開されていません。そこで本記事では、DeNAの事例のポイントを整理したうえで、同じ考え方の仕組みを自分たちの組織で作るためのサンプル一式を、ファイル単位のコード付きで紹介します。そのままコピーして、自社の資料に合わせて書き換えれば動く状態を目指しました。
DeNAの事例をおさらい
出発点は、受け入れ担当の立場から見えていた3つの課題でした。記事ではそれぞれに次のアプローチを当てています。
| 課題 | 中身 | アプローチ |
|---|---|---|
| 情報の散らばり | 手順はConfluence、仕様書はGoogle Drive、進捗はスプレッドシート、質問はSlackと分散し、古い資料も混在 | 情報への導線を1つのGitHubリポジトリに集約 |
| 個人スキルへの依存 | 分析職でもいきなりDockerやCLI認証が必要で、初日で終わる人と2週間かかる人が出る | Claude Codeが伴走する |
| 受け入れ工数が読めない | 人が変わるたびに同じ説明を繰り返す | 環境構築を可能な範囲で自動化 |
新規メンバーはリポジトリをcloneしてClaude Codeを起動し、スラッシュコマンド(スキル)でオンボーディングを進めます。設計の核になっているのは、次の3つの判断です。
- 教材の本文をリポジトリに持たない:最初はConfluenceの内容をMarkdownに転記していたものの、転記した瞬間に正本との二重管理になって腐ることに気づき方針転換。リポジトリには「正本がどこにあるか」と「何を身につけるべきか」だけを置き、本文は実行時にコネクタ経由で取りにいく形にしています。
- 出力の形を固定する:「次にやること」の案内が判断過程や条件分岐で埋もれる問題は、モデルの性能ではなくスキルの指示不足だったと結論づけ、出す情報・出さない情報をSKILL.mdで明文化。日報や改善メモもテンプレートで決め打ちにしています。
- AIにできないことを先に決める:コネクタの認証、ブラウザ操作、申請フォームは人の担当。正本が未登録なら推測で答えさせない、というルールもCLAUDE.mdに明記しています。
さらに興味深いのが検証方法です。配属予定だった新卒が来なかったため、AIエージェントに新規メンバー役を演じさせて初日のシナリオを6周通したところ、チェックリストの依存関係の矛盾(多要素認証より先にVPN確認が来る)、生成されたチェックリストのリンク切れ、ダウンロードしたスクリプト内に潜んでいた危険なコマンドなど、人間のレビューでは素通りしそうな問題が次々に見つかったそうです。
本記事のサンプルは、この3つの設計判断と「AI新人役によるリハーサル」をそのまま形にしています。加えて、記事で報告されていた不具合を機械的に検出するチェックスクリプトと危険なコマンドを止めるガードレール(フック)を足しました。
今回作るリポジトリの全体像
ディレクトリ構成は次のとおりです。DeNAの構成をベースに、チェック用のスクリプトとCIを追加しています。
analyst-onboarding/
├── CLAUDE.md                        # 役割・情報の扱い・禁止事項
├── knowledge/
│   ├── sources.yml                  # 正本レジストリ(URL・IDはここだけに書く)
│   └── guide/                       # ゴール・勘所・完了判定(手順本文は書かない)
│       ├── 00-account.md
│       └── 01-env-setup.md
├── docs/
│   ├── templates/
│   │   ├── checklist.md             # 進捗の単一の情報源(テンプレート)
│   │   └── improvements.md          # 改善メモのテンプレート
│   └── rehearsal.md                 # AI新人役のリハーサル用プロンプト
├── scripts/
│   └── validate.py                  # 整合性チェック
├── workspace/                       # 個人作業ディレクトリ(YYYY/名前/)
├── .github/workflows/validate.yml   # PRごとに整合性チェック
└── .claude/
    ├── settings.json                # 権限ルールとフック
    ├── hooks/guard-bash.sh          # 危険なコマンドの遮断
    └── skills/
        ├── setup-connectors/SKILL.md
        ├── kickoff/SKILL.md
        ├── onboarding/SKILL.md
        ├── ask/SKILL.md
        ├── daily-report/SKILL.md
        ├── feedback/SKILL.md
        └── maintain/SKILL.md
用意するスキルは7つです。
| スキル | 使う人 | 用途 |
|---|---|---|
/setup-connectors | 新規メンバー | 正本を読むためのコネクタ接続を確認(初日に1回) |
/kickoff <名前> | 新規メンバー | ワークスペース・ブランチ・Draft PRを作成(初日に1回) |
/onboarding next|progress | 新規メンバー | 次にやるタスクの案内/フェーズ別の進捗表示 |
/ask <質問> | 新規メンバー | 正本を引いて質問に回答し、人に聞くべきかを振り分け |
/daily-report | 新規メンバー | 日報を生成してコミット |
/feedback <気づき> | 新規メンバー | 教材への改善提案を5項目で蓄積 |
/maintain | 受け入れ担当 | 教材の鮮度点検と改善メモの反映 |
なお、DeNAの記事ではワークスペース作成のスキルを/initと呼んでいますが、Claude Codeには同名の組み込みコマンド(CLAUDE.mdを生成するもの)があり、同じ名前のプロジェクトスキルを置くとローカルのターミナルでは組み込み側が置き換わります。混乱を避けるため、本記事では/kickoffという名前にしています。
ステップ1:正本レジストリ(sources.yml)を作る
「本文を持たない」設計の中心になるファイルです。正本のURLやページID、ファイルIDを書いてよい場所はこのファイルだけにします。ガイドやチェックリストからは、ここで定義したidだけを参照します。
# knowledge/sources.yml
# 正本の所在はここにだけ書く。ガイド・チェックリストには id だけを書く。
# 見出し(アンカー)は書かない。正本側で見出しが変わった瞬間に参照が切れるため。
sources:
  - id: account-setup
    title: 社内アカウント初期設定手順
    system: confluence
    page_id: "100000001"
    url: https://example.atlassian.net/wiki/spaces/DS/pages/100000001

  - id: vpn-mfa
    title: 多要素認証とVPNの設定手順
    system: confluence
    page_id: "100000002"
    url: https://example.atlassian.net/wiki/spaces/IT/pages/100000002

  - id: env-setup
    title: 分析環境構築手順
    system: confluence
    page_id: "100000003"
    url: https://example.atlassian.net/wiki/spaces/DS/pages/100000003

  - id: data-spec
    title: データ仕様書(最新の承認済版)
    system: gdrive
    # 版が上がる資料は固定IDを持たせず「辿り方」を書く
    resolve:
      catalog_folder_id: "1AbCdEfGhIjKlMnOp"
      pick: latest_approved
      version_from: filename      # 例: データ仕様書_v3.2_承認済.pdf
      never_use: modified_time    # 承認後の軽微な編集でも更新日時は動くため

  - id: qa-history
    title: 過去の質問ログ(補助情報)
    system: slack
    channel: "#analyst-onboarding-qa"
optional: trueポイントはdata-specの書き方です。DeNAの記事では、版が上がる仕様書の最新版を更新日時で判定させたところ、承認済みの古い版に後から編集が入っていたせいで古い版を参照してしまう問題が起きたと報告されています。そこで固定IDではなく「カタログから最新の承認済版を、ファイル名の版表記で選ぶ」という解決ルールを書いておきます。
ステップ2:学習ガイドとチェックリストを書く
学習ガイド(knowledge/guide/)
ガイドには「ゴール」「勘所」「完了判定」だけを書き、手順そのものは書きません。正本への参照は正本: <id>の1行だけです。
# 01 分析環境を立ち上げる

正本: env-setup

## ゴール
- 分析用コンテナを起動し、ノートブックからサンプルクエリが通る状態にする

## 勘所
- CLIで認証する前に、一度ブラウザでSSOログインを済ませておくと詰まりにくい
- 社内ネットワークではコンテナイメージの取得に失敗しやすい。詰まったら /ask で相談する
- 「動いたけれど理由がわからない」状態で先に進まない。わからない点は日報に書く

## 完了判定
- 正本に記載の動作確認コマンドが成功している
- 確認結果を当日の日報の「やったこと」に記録している
チェックリストのテンプレート(docs/templates/checklist.md)
進捗の単一の情報源です。依存関係を(needs: #番号)の形で明示しておくと、後述のチェックスクリプトで「依存先が後ろにある」矛盾を機械的に見つけられます。
# オンボーディング チェックリスト
完了したら [ ] を [x] にしてコミットしてください。

## フェーズ1:アカウントと接続
- [ ] #01 社内アカウントの初回ログイン
  - ガイド: [00 アカウントを準備する](../../../knowledge/guide/00-account.md)
- [ ] #02 多要素認証の設定 (needs: #01)
- [ ] #03 VPN接続の確認 (needs: #02)

## フェーズ2:分析環境
- [ ] #04 分析環境の構築 (needs: #03)
  - ガイド: [01 分析環境を立ち上げる](../../../knowledge/guide/01-env-setup.md)
- [ ] #05 データ仕様書の読み込み (needs: #04)

## フェーズ3:実務の型
- [ ] #06 過去案件のノートブックを読む (needs: #05)
- [ ] #07 練習課題のSQLを自力で書く (needs: #05)リンクが../../../から始まっているのは、このテンプレートがworkspace/2026/名前/checklist.mdにコピーされて使われるからです。DeNAの事例では、テンプレートの位置を基準に相対パスを書いていたため、コピー後のリンクが44件すべて切れていたそうです。「どこで読まれるファイルなのか」を基準にパスを書くのがコツです。
ステップ3:CLAUDE.mdに役割と約束事を書く
CLAUDE.mdはセッションのたびに読み込まれる指示書です。手順ではなく、どんな場面でも守ってほしい原則だけを短く書きます。
# オンボーディング支援エージェントの約束事

## あなたの役割
新規メンバーが「案件にアサインできる状態」になるまで伴走する。
部のことなら何でも答える汎用Botではない。範囲外の質問は受け入れ担当(@onboarding-buddy)につなぐ。

## 情報の扱い
- 手順の本文はリポジトリに書かない。必要なときに knowledge/sources.yml の id からコネクタで正本を取得する
- 正本が未登録、または取得できない場合は推測で埋めない。
  「正本が未登録のため、受け入れ担当に所在を確認してください」と答える
- 取得結果に欠けがありそうなとき(「下表のとおり」とあるのに表がない等)は、取得形式を変えて取り直す。
  それでも欠けていれば、欠けている可能性があることを明示して伝える
- 長いページは全文を取らず、必要なセクションに絞って取得する
- 版が動く資料は sources.yml の resolve ルールに従う。更新日時で最新版を判断しない

## 人とAIの分担
- AI:CLIで完結する作業(必ず承認を得てから実行)、手順の要約、日報の下書き
- 人:コネクタの認証(/mcp)、ブラウザ操作、申請フォーム、第三者への依頼、教材の正しさの判断
- 自力で書くこと自体が学習目的の課題(チェックリストの「自力で」と書かれた項目)は代わりに解かず、ヒントにとどめる

## 禁止事項
- sudo、rm -rf、ダウンロードしたスクリプトの中身を確認しないままの実行
- 正本の内容をリポジトリへ転記すること
- main ブランチへの直接 push
「自力で解くべき課題は代わりに解かない」という一文は、DeNAの記事で利用者から好評だった点を反映したものです。AIに頼れる部分と、自分の力をつけるべき部分の線引きをエージェント側に持たせておくと、オンボーディングが「AIに丸投げして終わり」になりません。
ステップ4:スキルを書く
スキルは.claude/skills/<スキル名>/SKILL.mdに置きます。先頭のYAMLフロントマターで説明や引数のヒントを書き、その下に手順を書きます。副作用のあるスキル(ファイル作成やコミットを伴うもの)にはdisable-model-invocation: trueを付け、Claudeが勝手に起動せず、本人がスラッシュコマンドで呼んだときだけ動くようにしています。
/setup-connectors:コネクタの接続確認
本文を持たない設計は、正本を取りにいけることが大前提です。DeNAの記事にあるとおり、コネクタの認証はAI側からは実行できないため、確認だけをAIに任せ、認証そのものは本人に案内します。
---
name: setup-connectors
description: 教材の正本(Confluence / Google Drive / Slack)を読むためのコネクタ接続を確認する。オンボーディング初日に最初の1回だけ実行する。
disable-model-invocation: true
---

knowledge/sources.yml に登場する system(confluence / gdrive / slack)ごとに、
対応するコネクタのツールが使えるかを確認してください。

1. system ごとに、sources.yml の該当する正本を1件だけ試しに取得する
2. 結果を次の表で報告する(必須:Atlassian、Google Drive/任意:Slack)

   | コネクタ | 区分 | 状態 | 次にやること |

3. 未接続のものがあれば、あなたは認証できないので
   「/mcp を開いて ○○ を認証してください」とだけ案内し、認証後にもう一度このスキルを実行するよう伝える
4. 必須がすべて接続済みなら「次は /kickoff <あなたの名前> を実行してください」と伝えて終える
自前でMCPサーバーを立てず、Claude Codeから使えるコネクタだけに絞るのもDeNAの判断を踏襲しています。初日に「まずMCPサーバーを構築しましょう」となっては本末転倒なので、新規メンバーの作業はブラウザでの認証1回に収めます。claude.aiで設定したコネクタをClaude Codeから使う方法は、Claude Codeの公式ドキュメントで案内されています。
/kickoff:ワークスペースとDraft PRの作成
進捗管理をブランチとPRで回すことで、コミットやレビューの練習も兼ねる仕組みです。allowed-toolsに書いたコマンドは、このスキルを呼んだターンに限って確認なしで実行できます。
---
name: kickoff
description: 新規メンバーの個人ワークスペース、作業ブランチ、Draft PRを作る。/setup-connectors の後に1回だけ実行する。
disable-model-invocation: true
argument-hint: "[名前(ローマ字)]"
allowed-tools: Bash(date *) Bash(mkdir *) Bash(cp *) Bash(git switch *) Bash(git add *) Bash(git commit *) Bash(git push *) Bash(gh pr create *)
---

新規メンバー「$ARGUMENTS」のオンボーディングを開始します。今年は !`date +%Y` 年です。

1. workspace/<今年>/$ARGUMENTS/ を作り、次を用意する
   - docs/templates/checklist.md をコピーして checklist.md にする
   - docs/templates/improvements.md をコピーして notes/improvements.md にする
   - 空の daily_report/ ディレクトリ(.gitkeep を置く)
2. onboarding/$ARGUMENTS ブランチを作成してコミットし、push する
3. gh pr create --draft で「[Onboarding] $ARGUMENTS」という Draft PR を作る
4. 最後に「次は /onboarding next で最初のタスクを確認しましょう」とだけ伝える
/onboarding:次のタスク案内と進捗表示
DeNAが最も試行錯誤したのがこのスキルの出力品質です。判断の過程を並べない、リンクを示すだけで終わらない、条件分岐を全部展開しない、という3つのルールを、出力テンプレートとセットで書き込みます。
---
name: onboarding
description: オンボーディングの次のタスク案内(next)とフェーズ別の進捗表示(progress)。「次は何をすればいい?」「どこまで進んだ?」と聞かれたときに使う。
argument-hint: "[next | progress]"
allowed-tools: Bash(git branch *)
---

モード:$ARGUMENTS(指定がなければ next)
現在のブランチ:!`git branch --show-current`

ブランチ名 onboarding/<名前> から workspace/*/<名前>/checklist.md を特定して読み、
モードに応じて答えてください。

## next のとき
1. 未完了の項目のうち、needs の項目がすべて完了しているもので、番号が最も小さいものを1つ選ぶ
2. その項目のガイドにある「正本: <id>」を sources.yml で引き、コネクタで正本を取得して読む
3. 次の形だけで出力する。これ以外のことは書かない

   **次のタスク:#<番号> <タイトル>**
   ゴール:<ガイドのゴールを1行で>
   手順:
   1. <正本を読んだうえで3〜5ステップに圧縮した正常系の手順>
   完了したら:<ガイドの完了判定>
   うまくいかなかったら、詰まったところをそのまま教えてください。

## 出力ルール
- スキップした項目の理由、進捗の推測、受け入れ担当側のタスクは書かない(聞かれたら答える)
- 手順書の条件分岐(「Intel版の場合は〜」など)は展開しない。正常系だけを書く
- 複数画面のスクリーンショットが前提の手順だけは、要点1行と「正本を開いて確認してください」に加えて
  sources.yml の url を示すにとどめる
- 正本が取得できなければ手順を推測せず、受け入れ担当への確認を促す

## progress のとき
フェーズごとに「完了数 / 全体」と、未完了の項目タイトルだけを表にする。
!`git branch --show-current`の行は、スキルの内容がClaudeに渡る前にコマンドが実行され、その出力に置き換わる仕組み(動的コンテキストの注入)です。毎回「いまのブランチを確認して」と指示しなくても、最初から現在地がわかった状態で応答できます。
最後の「うまくいかなかったら、詰まったところを教えて」という一文には、DeNAの記事でも触れられていたとおり、AIに慣れていない人に「とりあえず聞けば何とかなる」という感覚を持ってもらう狙いがあります。分岐をあらかじめ全部書くより、詰まったときに相談してもらうほうが、案内も短く読みやすくなります。
/ask:正本を引いて答え、人に聞くべきかを振り分ける
DeNAの利用者の感想で特に印象的だったのが、「この理解で合っているか」を正本から判断できるものと、受け入れ担当に聞くべきものに振り分けてくれる点でした。そこで回答に「確度」の欄を設け、振り分けを明示させます。
---
name: ask
description: オンボーディング中の疑問に、登録済みの正本を引いて答える。「これどこに書いてあった?」「この理解で合ってる?」など、教材や業務の進め方に関する質問で使う。
argument-hint: "<質問>"
---

質問:$ARGUMENTS

1. knowledge/guide/ と knowledge/sources.yml から、質問に関係する正本の id を最大3件選ぶ
2. コネクタで正本を取得する。長いページは関係するセクションだけを取る
3. 次の形で答える
   - **回答**:結論を先に書き、根拠にした正本のタイトルを添える
   - **確度**:「正本に明記」「正本から推論」「正本に記載なし」のいずれか
   - **人に聞くべきか**:確度が「推論」「記載なし」のときは、受け入れ担当に聞く論点を1〜2行に整理する
4. 正本に記載がなければ推測で答えず、確度を「記載なし」にする
5. 過去の質問ログ(qa-history)は補助情報として扱う。正本と食い違う場合は正本を優先し、食い違いがあることも伝える
人に聞く前に論点が整理されるので、受け入れ担当に届く質問の粒度が揃っていく効果も期待できます。
/daily-report:日報の生成
DeNAでは当初「AIが質問してから日報を書く」流れにしていたものの、行動記録から客観的に書けるのはAIのほうだと気づき、事実はAIが書き、本人は自由記述だけを書く構成に変えたそうです。サンプルもその形にしています。
---
name: daily-report
description: 今日の作業記録から日報を生成し、ワークスペースに保存してコミットする。終業時に実行する。
disable-model-invocation: true
allowed-tools: Bash(git log *) Bash(git add *) Bash(git commit *) Bash(git push *)
---

## 今日のコミット
!`git log --since=midnight --oneline`

## 手順
1. 今日の会話、上のコミット、checklist.md の変更から、事実ベースで下書きする
2. checklist.md と食い違い(作業は終わったのに [ ] のまま等)があれば指摘し、直すか本人に確認する
3. 本人に「ひとこと(自由記述)」を1回だけ聞く
4. 次のテンプレートで daily_report/YYYY-MM-DD.md に保存し、コミットして push する
   見出しの増減や並べ替えはしない

# 日報 YYYY-MM-DD
## やったこと
## つまったこと(どう解決したか/未解決か)
## 学んだこと
## 明日やること
## ひとこと(本人記入)
毎営業日コミットされるので、受け入れ担当はDraft PRを眺めるだけで「どこで詰まったか」まで非同期で追えるようになります。
/feedback:改善提案を5項目で溜める
オンボーディング中の「わかりにくかった」を、そのまま教材の改善につなげるためのスキルです。項目を固定しておくと、受け入れ担当が後でまとめて処理しやすくなります。
---
name: feedback
description: 教材や手順のわかりにくさ・誤りを improvements.md に記録する。「この手順おかしい」「わかりにくい」と感じたときに使う。
argument-hint: "<気づいたこと>"
---

気づき:$ARGUMENTS

ワークスペースの notes/improvements.md の末尾に、次の5項目で1件追記してください。
項目の増減はしないこと。本人の言葉が曖昧なら、書く前に1つだけ質問してよい。

### <短いタイトル>
- ステータス:未対応
- 現状:<いま教材・手順がどうなっているか>
- 問題:<何が起きたか、なぜ困ったか>
- 改善案:<どう直すと良いか。正本側を直すのか、ガイド側を直すのか>
- 参照:<正本の id/ガイドのファイル名/チェックリストの番号>
DeNAの事例では、権限確認の手順が実態と合っていない、理解度チェックがどの教材にも書かれていない内容を問うている、といった指摘が実際に上がってきたそうです。従来なら「自分の読み落としかも」と飲み込まれていた気づきが、書く場所さえあれば教材の資産に変わります。
/maintain:受け入れ担当向けの鮮度点検
---
name: maintain
description: 教材の鮮度点検と、集まった改善メモの反映案づくりを行う(受け入れ担当向け)。
disable-model-invocation: true
---

1. python3 scripts/validate.py を実行し、エラーがあれば一覧にする
2. sources.yml の各正本をコネクタで取得し、
   取得できない/極端に短い/表や画像が欠けている疑いがあるものを報告する
3. workspace/*/*/notes/improvements.md から「未対応」を集め、
   「正本側で直すもの」と「リポジトリ側で直すもの」に分けて表にする
4. リポジトリ側の修正は差分案を示し、承認されたらブランチを切ってPRにする
   (正本の本文をリポジトリに書いてはいけない)
ステップ5:整合性チェックを自動化する
DeNAの記事で、AI新人役のリハーサルによって見つかった問題のうち、依存関係の矛盾とリンク切れは機械的にチェックできます。また「正本のURLはsources.ymlにしか書かない」という規約も、人の注意力に頼ると必ずどこかで破られます。そこで、これらをまとめて検査するスクリプトを用意します。
#!/usr/bin/env python3
"""オンボーディングリポジトリの整合性チェック(pip install pyyaml が必要)"""
import re
import sys
from pathlib import Path

import yaml

ROOT = Path(__file__).resolve().parent.parent
SOURCE_HOSTS = ("atlassian.net", "docs.google.com", "drive.google.com")
REF_RE = re.compile(r"正本:\s*([A-Za-z0-9_\-]+)")
LINK_RE = re.compile(r"\]\((?!https?://|#)([^)]+)\)")
ITEM_RE = re.compile(r"^- \[[ x]\] #(\d+)\s+(.+?)(?:\s+\(needs:\s*([#\d,\s]+)\))?\s*$")

errors = []


def rel(path):
    return path.relative_to(ROOT)


def load_source_ids():
    data = yaml.safe_load((ROOT / "knowledge/sources.yml").read_text(encoding="utf-8"))
    return {s["id"] for s in data["sources"]}


def check_refs_and_urls(ids):
    """未登録の正本IDの参照と、sources.yml 以外への正本URLの記載を検出"""
    targets = list((ROOT / "knowledge/guide").rglob("*.md")) + list((ROOT / "docs").rglob("*.md"))
    for md in targets:
        text = md.read_text(encoding="utf-8")
        for ref in REF_RE.findall(text):
            if ref not in ids:
                errors.append(f"{rel(md)}: sources.yml に未登録の正本ID '{ref}'")
        for host in SOURCE_HOSTS:
            if host in text:
                errors.append(f"{rel(md)}: 正本のURL({host})は sources.yml 以外に書かない")


def check_dependencies(checklist):
    """番号順に進めたとき、まだ出てきていない項目に依存していないか"""
    seen = set()
    for n, line in enumerate(checklist.read_text(encoding="utf-8").splitlines(), 1):
        m = ITEM_RE.match(line)
        if not m:
            continue
        num, _title, needs = m.groups()
        for dep in re.findall(r"\d+", needs or ""):
            if dep not in seen:
                errors.append(f"{rel(checklist)}:{n}: #{num} が後ろにある #{dep} に依存しています")
        seen.add(num)


def check_links(md, base_dir):
    """相対リンクが base_dir 基準で実在するか"""
    for target in LINK_RE.findall(md.read_text(encoding="utf-8")):
        path = (base_dir / target.split("#")[0]).resolve()
        if not path.exists():
            errors.append(f"{rel(md)}: リンク切れ {target}({rel(base_dir)} に置かれた前提)")


def main():
    ids = load_source_ids()
    check_refs_and_urls(ids)

    template = ROOT / "docs/templates/checklist.md"
    check_dependencies(template)
    # テンプレートは workspace/YYYY/名前/ にコピーされて使われるので、その位置で検査する
    check_links(template, ROOT / "workspace/2026/_sample")

    for md in (ROOT / "knowledge/guide").rglob("*.md"):
        check_links(md, md.parent)

    if errors:
        print("\n".join(errors))
        sys.exit(1)
    print("OK: 問題は見つかりませんでした")


if __name__ == "__main__":
main()このスクリプトの肝は、テンプレートのリンクをテンプレートの置き場所ではなく、コピーされた先の位置で検査している点です。テンプレートを開いたときに正常に見えても、実際に使われる場所で切れていれば意味がありません。依存関係のチェックも、「番号順に素直に進めると詰む」という、教材を読み慣れた人ほど見落とす矛盾を検出するためのものです。
PRごとに自動で走らせておけば、教材を更新した人が規約を破ってもマージ前に気づけます。
# .github/workflows/validate.yml
name: validate-onboarding
on: pull_request

jobs:
  validate:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-python@v5
        with:
          python-version: "3.12"
      - run: pip install pyyaml
      - run: python scripts/validate.py
ステップ6:危険なコマンドを止めるガードレール
DeNAの記事では、Driveからダウンロードして実行する手順のスクリプトの中に、システムを壊しかねない削除コマンドが13行も含まれていたと報告されています。AIから見えるのは「スクリプトを実行する」というコマンド文字列だけなので、コマンドの禁止パターンをいくら並べても、スクリプトの中身までは止められません。
そこで2段構えにします。まずsettings.jsonの権限ルールで、明らかに危険なコマンドを拒否します。
{
  "permissions": {
    "deny": [
      "Bash(sudo *)",
      "Bash(rm -rf *)"
    ]
  },
  "hooks": {
    "PreToolUse": [
      {
        "matcher": "Bash",
        "hooks": [
          {
            "type": "command",
            "command": "\"$CLAUDE_PROJECT_DIR\"/.claude/hooks/guard-bash.sh"
          }
        ]
      }
    ]
  }
}次に、コマンドの実行直前に呼ばれるPreToolUseフックで、実行しようとしているスクリプトファイルの中身まで検査します。フックが終了コード2で終わるとClaude Codeはその実行をブロックし、標準エラーに書いた理由をClaudeに返します。
#!/usr/bin/env bash
# .claude/hooks/guard-bash.sh
# Bash の実行前に、コマンド本体と「実行されるスクリプトの中身」を検査する
set -u

INPUT=$(cat)
CMD=$(printf '%s' "$INPUT" | jq -r '.tool_input.command // empty')

# 危険なパターン(sudo、rm -rf 系、mkfs、dd、curl をパイプでシェルに渡す、など)
DANGER='(^|[;&|[:space:]])(sudo|mkfs|dd[[:space:]]+if=)|rm[[:space:]]+-[a-zA-Z]*([rR][a-zA-Z]*f|f[a-zA-Z]*[rR])|curl[^|]*\|[[:space:]]*(ba|z)?sh'

block() {
  echo "Blocked: $1 実行せずに、受け入れ担当に確認するよう本人に伝えてください。" >&2
  exit 2
}

if printf '%s' "$CMD" | grep -Eq "$DANGER"; then
  block "危険なコマンドパターンを検出しました($CMD)。"
fi

# スクリプトを実行するコマンドなら、ファイルの中身も検査する
for f in $(printf '%s' "$CMD" | grep -Eo '[^[:space:]]+\.(sh|bash|zsh)'); do
  if [ -f "$f" ] && grep -Eq "$DANGER" "$f"; then
    block "スクリプト $f の中に危険なコマンドが含まれています。"
  fi
done

exit 0スクリプトにはchmod +x .claude/hooks/guard-bash.shで実行権限を付け、JSONの解析用にjqを入れておきます。もちろん、このような文字列チェックはすり抜けようと思えばいくらでもすり抜けられる「ベストエフォート」のガードレールです。あくまでうっかり事故を防ぐ層の1つと位置づけ、mainブランチの保護や、権限の強い操作は人が行うという分担と組み合わせて使ってください。
ステップ7:AIに新人役を演じさせてリハーサルする
仕組みができたら、実際の新規メンバーを迎える前にAIで通しリハーサルをします。作った本人が触っても、前提が全部頭に入っているので詰まりません。指示どおりにしか動かない新人役を用意することで、はじめて行間の抜けが表に出ます。
<!-- docs/rehearsal.md -->
あなたは今日配属された新規メンバー役です。
統計やデータ分析は得意ですが、Docker・CLI・Git にはほとんど触ったことがありません。
次のルールでオンボーディング初日を最後まで進め、詰まった箇所を報告してください。

- チェックリストとガイドに書かれていることだけを根拠に、番号順に素直に進める(行間を補わない)
- 実際のコマンドは実行せず、「実行するとしたら何を入力するか」を書く
- 書かれていない前提知識が必要になったら、その時点で「詰まり」として記録して先に進む
- リンクはすべて開いて、存在することを確かめる

今回は特に「{{FOCUS}}」の観点で重点的に確認してください。

報告形式:
| # | 項目 | 何が起きたか | 原因の推定 | 直すべき場所(正本/ガイド/チェックリスト) |観点を変えて何周も回すのがポイントです。DeNAの事例では6周目でもまだ新しい問題が出てきたそうです。ヘッドレス実行(claude -p)とplanモードを組み合わせれば、ファイルを書き換えずに読むだけのリハーサルを観点ごとにまとめて回せます。
#!/usr/bin/env bash
# scripts/rehearse.sh : 観点を変えて新人役リハーサルを回す
mkdir -p rehearsal
for focus in 依存関係 リンク 危険な操作 用語のわかりにくさ 完了判定のあいまいさ; do
  prompt=$(sed "s/{{FOCUS}}/${focus}/" docs/rehearsal.md)
  claude -p "$prompt" --permission-mode plan > "rehearsal/${focus}.md"
  echo "done: ${focus}"
done
出てきた詰まりは/feedbackと同じ5項目に整理して改善メモに入れておくと、本番の新規メンバーから上がってくる指摘と同じ流れで処理できます。ただし、DeNAの記事が最後に強調しているとおり、一番のバグ発見器はその仕組みを初めて使う生身の人間です。AIのリハーサルはあくまで「本番前の代用」と割り切り、本番で上がってきた指摘を拾う仕組み(/feedbackと/maintain)のほうを丁寧に回しましょう。
新規メンバーの初日はこうなる
ここまでのファイルを置いたリポジトリを渡すと、新規メンバーの体験は次のような流れになります。
- リポジトリをcloneしてClaude Codeを起動し、
/setup-connectorsを実行。未接続のコネクタがあれば/mcpから認証する /kickoff taroでワークスペースとDraft PRができる/onboarding nextで最初のタスクが3〜5ステップに圧縮されて出てくる。終わったらチェックを付けて、また/onboarding next- 途中の疑問は
/askへ。正本に書いてあることはその場で解決し、書いていないことは論点を整理して人に聞く - 引っかかった点は
/feedbackで記録 - 終業時に
/daily-reportで日報をコミット
受け入れ担当がやることは、リポジトリのURLを渡して最初の2つのコマンドを伝えることと、Draft PRに積み上がる日報を読んで必要なときに声をかけることです。オンボーディングが終わったら/maintainで改善メモを棚卸しし、次の受け入れまでに教材を一段よくしておきます。
まとめ
DeNAの取り組みから学べるいちばん大きなポイントは、リポジトリに集約すべきは情報そのものではなく「導線」だという発想の転換でしょう。本文を転記した瞬間に資料は腐り始めますが、「どこに正本があるか」と「何を身につけるべきか」だけを持つ構造なら、正本が更新されてもリポジトリ側は古くなりません。その本文を必要なときに取りにいき、読みやすく圧縮して差し出す役をAIエージェントが担う、という分担がよくできています。
もう1つは、AIの出力品質の多くはモデルではなく指示の書き方で決まる、という点です。何を出して何を出さないか、どんな形で出すかをスキルに書き切ること、そしてAIにできないことを先に決めておくこと。本記事のサンプルは、この2点をそのままファイルに落としたものです。
社内の資料がConfluenceやGoogle Driveに散らばっていて、受け入れのたびに同じ説明を繰り返している組織なら、まずはsources.ymlと/onboarding、/askの3つから始めてみるのがおすすめです。小さく作り、新しいメンバーが来るたびに/feedbackで育てていけば、「作って終わり」にならないオンボーディングの仕組みになっていくはずです。
本記事は、DeNA Engineering Blogの記事およびClaude Codeの公式ドキュメント(いずれも2026年10月19日時点の情報)をもとに、筆者が独自にサンプルを作成したものです。サンプルコードはDeNAのリポジトリそのものではなく、記事で紹介されている設計方針を参考に再構成したものです。Claude Codeのスキル・フック・コネクタの仕様は今後変更される可能性があるため、導入の際は必ず公式ドキュメントで最新の仕様をご確認ください。また、ガードレールとして紹介したフックは完全な防御ではないため、権限設計やブランチ保護と併用してください。
参考情報
- オンボーディングをAIエージェントに任せたら、もはや別ゲーだった(DeNA Engineering Blog)
- Extend Claude with skills(Claude Code ドキュメント)
- Automate actions with hooks(Claude Code ドキュメント)
- Manage Claude’s memory / CLAUDE.md(Claude Code ドキュメント)
- Connect Claude Code to tools via MCP(Claude Code ドキュメント)
- Run Claude Code programmatically(Claude Code ドキュメント)
- Claude Code settings(Claude Code ドキュメント)