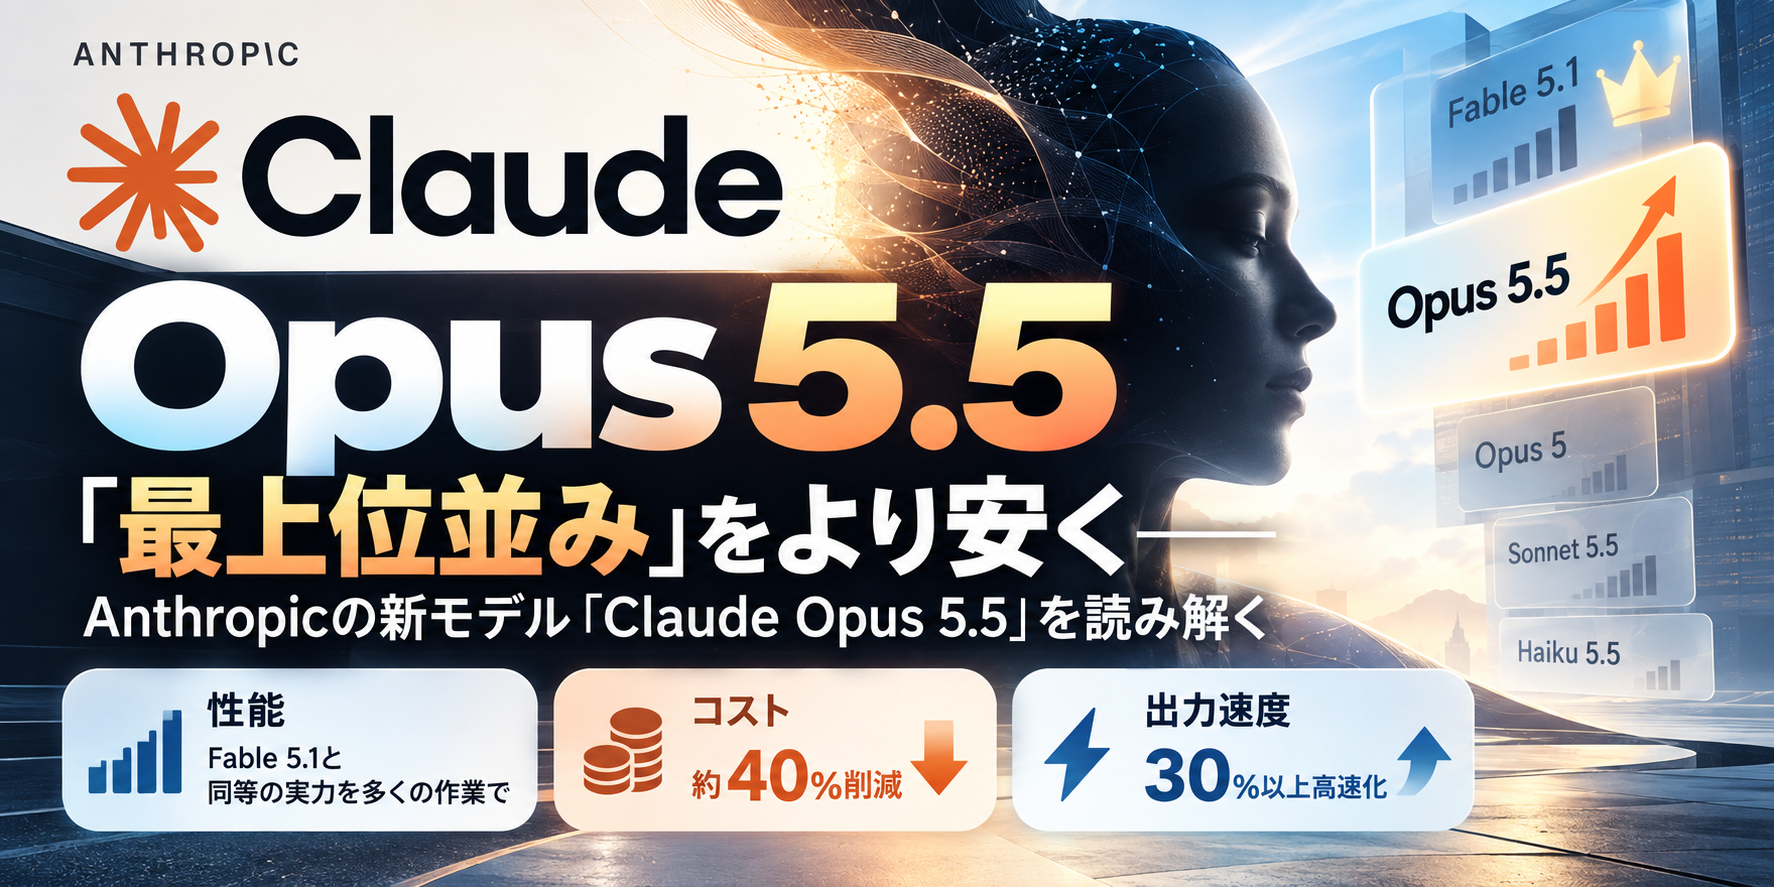
2026年9月22日(米国時間)、Anthropicは新モデルClaude Opus 5.5を発表しました。うたい文句は「ほとんどの作業で最上位モデルClaude Fable 5.1と同等の性能を、はるかに安く」。前モデルのOpus 5と比べて実際の運用コストは約40%下がり、出力速度は30%以上速くなったとされています。約2週間前にOpenAIが「AGI時代へようこそ」という強い言葉とともにGPT-6 Astraを出し、料金を前モデルの約2.5倍に引き上げたのとは対照的に、今回のAnthropicは「値下げして性能を上げる」方向で勝負してきた格好です。性能差、期待されること、費用の3つの軸で中身を整理してみます。
Claudeのモデル構成をおさらい
本題の前に、名前がややこしいので位置づけを確認しておきます。現在のClaudeには、大きく分けて次のような階層があります。
- Fable 5.1 / Mythos 5.1:Anthropicの最上位クラス。性能は最も高いが、料金も入力100万トークンあたり10ドル/出力50ドルと高価。Mythosはサイバーセキュリティや生物学などの高リスク領域向けに、信頼できる組織へ限定的に提供されている系列です。
- Opus:日常業務から高度なコーディングまで幅広く使う主力の上位モデル。今回の5.5はここにあたります。
- Sonnet / Haiku:より軽量・低価格なモデル。Sonnet 5.5とHaiku 5.5は「数週間以内」にリリース予定とされ、今回のOpus 5.5は「5.5世代」の第一弾という位置づけです。
つまりOpus 5.5は、「一段上の価格帯にあるFable 5.1の実力を、Opusの価格帯に降ろしてきた」モデルだと考えるとわかりやすいでしょう。
性能はどれくらい上がったのか
Anthropicや各種報道が公表しているベンチマークを、前モデルのOpus 5、最上位のFable 5.1、そしてOpenAIのGPT-6 Astraと並べると次のようになります。
| ベンチマーク(測っているもの) | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra |
|---|---|---|---|---|
| Terminal-Bench 4.0(ターミナル操作を伴うコーディング) | 66.4% | 55.8% | 52.3% | 57.9% |
| FrontierCode v1.1(難度の高いコーディング) | 54.4% | 50.3% | 48.0% | 53.3% |
| CursorBench 4.0(エディタ上の実務的なコーディング) | 57.8% | 51.8% | 46.6% | ─ |
| GDPval-AA v2.1(知的労働タスク、Eloスコア) | 1846 | 1735 | 1708 | 1542 |
| OSWorld 2.0(PC操作の自律実行) | 81.8% | 80.7% | 74.0% | ─ |
| Humanity’s Last Exam(ツール使用あり、超難問の知識・推論) | 67.7% | ─ | ─ | 57.2% |
| Terminal-Bench-Science 0.1(科学系の実験・解析タスク) | 58.7% | 52.6% | 29.0% | 64.6% |
| AutomationBench(複数SaaSをまたぐ業務自動化) | 40.0% | 31.4% | 26.9% | 41.4% |
コーディング系と知的労働系では、Opus 5.5がFable 5.1とGPT-6 Astraの両方を上回る結果が並びます。特にTerminal-Bench 4.0では、Opus 5から14ポイント以上伸び、Astraにも約9ポイントの差をつけています。一方で、科学系タスク(Terminal-Bench-Science)と、Zapierが設計した業務自動化ベンチマーク(AutomationBench)ではAstraがわずかに上回っており、「全方位で圧勝」というわけではありません。
なお、Anthropic自身が注意書きとして、一部の評価では同社の安全対策(後述)が作動し、サイバーセキュリティや生物学に近いタスクが旧モデルに回されたため、スコアが押し下げられた可能性があると述べています。
数字以外の実例としては、早期テスターが68万行規模のコード移行を1日かからずに完了した事例や、20万行のコードベースの監査・修正を3時間弱で終えた(Opus 5では20時間以上かかり、トークン消費も2.5倍だった)事例が紹介されています。ベンチマークよりも、この「長くて大きな仕事を短時間・少ないトークンでやりきる」点のほうが、実務では効いてきそうです。
何が期待されるのか
1. 最上位クラスの仕事を、日常的に回せるようになる
これまで「本当に難しいタスクだけFable 5.1を使い、普段はOpusで済ませる」という使い分けをしていた現場は多いはずです。Opus 5.5が多くの作業でFable 5.1並みに届いたことで、その使い分け自体が不要になるケースが増えるでしょう。とくに大規模リファクタリング、レガシーシステムの移行、コードレビューといった開発業務では、恩恵がわかりやすく出そうです。
2. 文章がわかりやすくなった
地味ながら、Anthropicは「コミュニケーションの向上」も改善点に挙げています。文章がより明確で理解しやすくなったとされ、出力トークン数もOpus 5より約40%少なくなったと報告されています。冗長な説明が減り、要点が伝わる回答になるのは、社内資料の下書きや顧客向けメールの作成など、ビジネス用途では歓迎されるポイントです。
3. 安全性とプロンプトインジェクション耐性の向上
Anthropicが実施している約2,000シナリオの自動行動監査では、Opus 5.5が「これまでテストした中で最も良いスコア」を記録したとされています。隔離環境からの逸脱を試みる頻度もOpus 5やMythos 5.1より約85%少なかったといいます。外部の評価機関であるFrontier DesignとMETRによる事前テストも行われています。
また、外部のWebページやファイルに仕込まれた悪意ある指示に従ってしまう「プロンプトインジェクション」への耐性も上がったとされています。AIエージェントに社内システムを触らせる場面が増えている今、これは実用上かなり重要な改善です。
ただし、システムカード(モデルの安全性に関する技術文書)では後退した点も正直に書かれています。貼り付けられた悪意ある指示に従いやすくなった場面がある、検証できない「権限がある」という主張を受け入れやすい、センシティブな話題で回答をはぐらかす傾向が増えた、などです。導入時にはこうした弱点も踏まえておくとよいでしょう。
4. 高リスク領域では「旧モデルに切り替える」仕組み
興味深いのが、安全対策の設計です。Opus 5.5はサイバーセキュリティと生物学の分野でMythos 5.1と同等の能力を持つとされるため、悪用を防ぐ多段階のチェックが組み込まれました。サイバー関連では、モデル内部の状態を調べる仕組み、軽量な分類器、別途学習させた分類器の3段構えで判定し、ブロック対象になったリクエストはOpus 4.8に回されます。生物学関連でも同様に、判定されたリクエストはOpus 5に回されます。
正当な研究目的で使いたい組織向けには、審査を経てアクセスを得られる「ライフサイエンス検証プログラム」が用意され、サイバー分野の「サイバー検証プログラム」も3段階のアクセスレベルに拡大される予定です。
費用はどうなったのか
API料金
| 項目(100万トークンあたり) | Opus 5.5 | Opus 5 | Fable 5.1 | GPT-6 Astra |
|---|---|---|---|---|
| 入力 | 4ドル | 5ドル | 10ドル | 10ドル |
| 出力 | 20ドル | 25ドル | 50ドル | 50ドル |
| キャッシュ読み取り | 0.20ドル | 0.50ドル | ─ | 1ドル |
| キャッシュ書き込み | 5ドル | 6.25ドル | ─ | ─ |
入力・出力ともにOpus 5から20%値下げ、繰り返し使う情報を再利用する「キャッシュ読み取り」は60%値下げです。Fable 5.1やGPT-6 Astraと比べると、単価はちょうど4割の水準になります。高速に応答する「Fastモード」は入力8ドル/出力40ドルと、通常の倍の料金設定です。
実際の負担はさらに下がる
ここで効いてくるのが、先ほど触れた「出力トークンが約40%少なくなった」点です。単価が20%下がり、しかも同じ仕事をこなすのに必要なトークン自体が減るため、Anthropicは典型的な業務で運用コストが約40%下がると説明しています。
ざっくりした試算をしてみましょう。入力100万トークン、出力20万トークンを使う作業があったとします。
- Opus 5:入力5ドル+出力5ドル=10ドル
- Opus 5.5(単価のみ反映):入力4ドル+出力4ドル=8ドル
- Opus 5.5(出力量が4割減った場合):入力4ドル+出力2.4ドル=約6.4ドル
- Fable 5.1 / GPT-6 Astra:入力10ドル+出力10ドル=20ドル
もちろんタスクの中身によって入出力の比率は大きく変わるので、あくまで目安です。とはいえ、「Fable 5.1並みの仕事を3分の1程度の費用で」という構図が見えてきます。ただしOpenAIには、入力2ドル/出力10ドルのGPT-6 Solや、さらに安価なGPT-6 Lunaといった下位モデルもあり、「そこまでの性能はいらない」用途ならより安い選択肢もあります。
サブスクリプションプラン
claude.aiのPro・Max・Teamプランでは、5時間ごとの利用上限が引き上げられました。さらに、サブスクリプション利用者には「レートリミットのリセット」が付与され、好きなタイミングで使えるようになっています。「大事な作業の途中で上限に達してしまった」という場面で、一度だけ上限を戻せる救済措置のようなものです。
開発者が気をつけたい変更点
APIで組み込んでいる場合は、いくつか互換性に関わる変更があります。
- 思考(thinking)を無効にできなくなった:これまでのように推論をオフにするのではなく、
effortパラメータで考える深さを調整する方式に変わりました。デフォルトの中程度(medium)でもFable 5.1クラスの性能が出るとされています。 - ツール使用の強制でエラーが返る場合がある
- 旧バージョンのコンピュータ操作ツール(
computer_20251124)が一部環境で使えなくなった - EU AI法への対応として、生成テキストに電子透かし(ウォーターマーク)が入る
コンテキストウィンドウは100万トークン、最大出力は12.8万トークン(バッチAPI経由なら最大30万トークン)です。モデルIDはclaude-opus-5-5で、Claude API(Claude Platform)のほか、AWS(Amazon Bedrock)、Google Cloud(Vertex AI)、Microsoft Azureから利用できます。
「ペース調整」を呼びかけた直後のリリース
今回の発表でもう一つ注目されているのが、タイミングです。AnthropicのDario Amodei CEOは9月12日、「フロンティアのペース調整(pacing the frontier)」と題した文章を公開し、①第三者の評価者を社内に常駐させて安全性を検証する、②民主主義国の主要AI企業が共通の安全基準と「歯止めのないAI進歩の速度」への制限を設ける、③権威主義国家とも危険な用途の禁止について協調を試みる、という3段階の案を示しました。OpenAIのSam Altman氏やxAIのElon Musk氏も賛意を示しています。
Opus 5.5は、その呼びかけ後に出る最初のモデルです。Anthropic自身も「ペース調整を呼びかけて以来初のモデル」と明言し、外部評価の実施や行動監査の結果を前面に出しています。「減速を訴えながら新モデルを出すのか」という批判的な見方がある一方で、今回は能力の天井を押し上げる最上位モデルではなく、既存の最上位(Fable 5.1)の水準を安く・効率よく提供するモデルである点を踏まえると、呼びかけと矛盾しない形を意識したリリースとも読めます。
まとめ
Claude Opus 5.5は、「性能を上げて値段も上げる」のではなく、「最上位並みの性能を、より安く・速く・少ないトークンで」という方向の進化です。コーディングや知的労働系のベンチマークではFable 5.1やGPT-6 Astraを上回る一方、科学系タスクや業務自動化ではAstraが僅差で優位な場面もあり、用途によって向き不向きはあります。
企業として検討するなら、次のような判断軸が現実的でしょう。
- いまFable 5.1を使っている業務:Opus 5.5への置き換えで、品質を保ったままコストを大きく下げられる可能性が高い
- いまOpus 5を使っている業務:ほぼそのまま移行して、性能向上とコスト減の両方が見込める。ただしthinkingやツール周りの仕様変更には要注意
- セキュリティ・生命科学系の業務:安全対策により旧モデルへ回される場合があるため、検証プログラムの利用も含めて事前に挙動を確認しておきたい
Sonnet 5.5・Haiku 5.5も数週間以内に登場予定で、「5.5世代」が出そろうと、Claudeの使い分けの地図はもう一度書き換わりそうです。
本記事は、Anthropicの公式発表および各種報道(2026年9月22日〜23日時点の情報)をもとに、一般向けにわかりやすく整理したものです。ベンチマーク数値は情報源によって多少の差異があり、開発元自身による数値である点は割り引いて見る必要があります。料金・提供範囲・仕様は今後変更される可能性があるため、実際の利用を検討する際は必ず公式情報をご確認ください。
参考情報
- Anthropic、「Claude Opus 5.5」を発表 – Impress Watch
- Anthropic releases Claude Opus 5.5, beating Fable 5.1 on key agentic benchmarks at 60% cheaper API price – VentureBeat
- Anthropic Releases Claude Opus 5.5: Fable 5.1-Level Performance at 40% Lower Running Cost Than Opus 5 – MarkTechPost
- Anthropic Releases Claude Opus 5.5, Beats GPT-6 Astra On Most Benchmarks – OfficeChai
- Claude Opus 5.5 Benchmarks Explained – Vellum
- Anthropic Releases Claude Opus 5.5 With Lower Pricing and New Safeguards – Unite.AI
- Anthropic Releases Claude Opus 5.5 – Thurrott.com
- Claude(@claudeai)の投稿:ペース調整後初のモデル
- Claude(@claudeai)の投稿:利用上限の引き上げとレートリミットのリセット
- Anthropic CEO outlines plan to slow AI development – TechCrunch