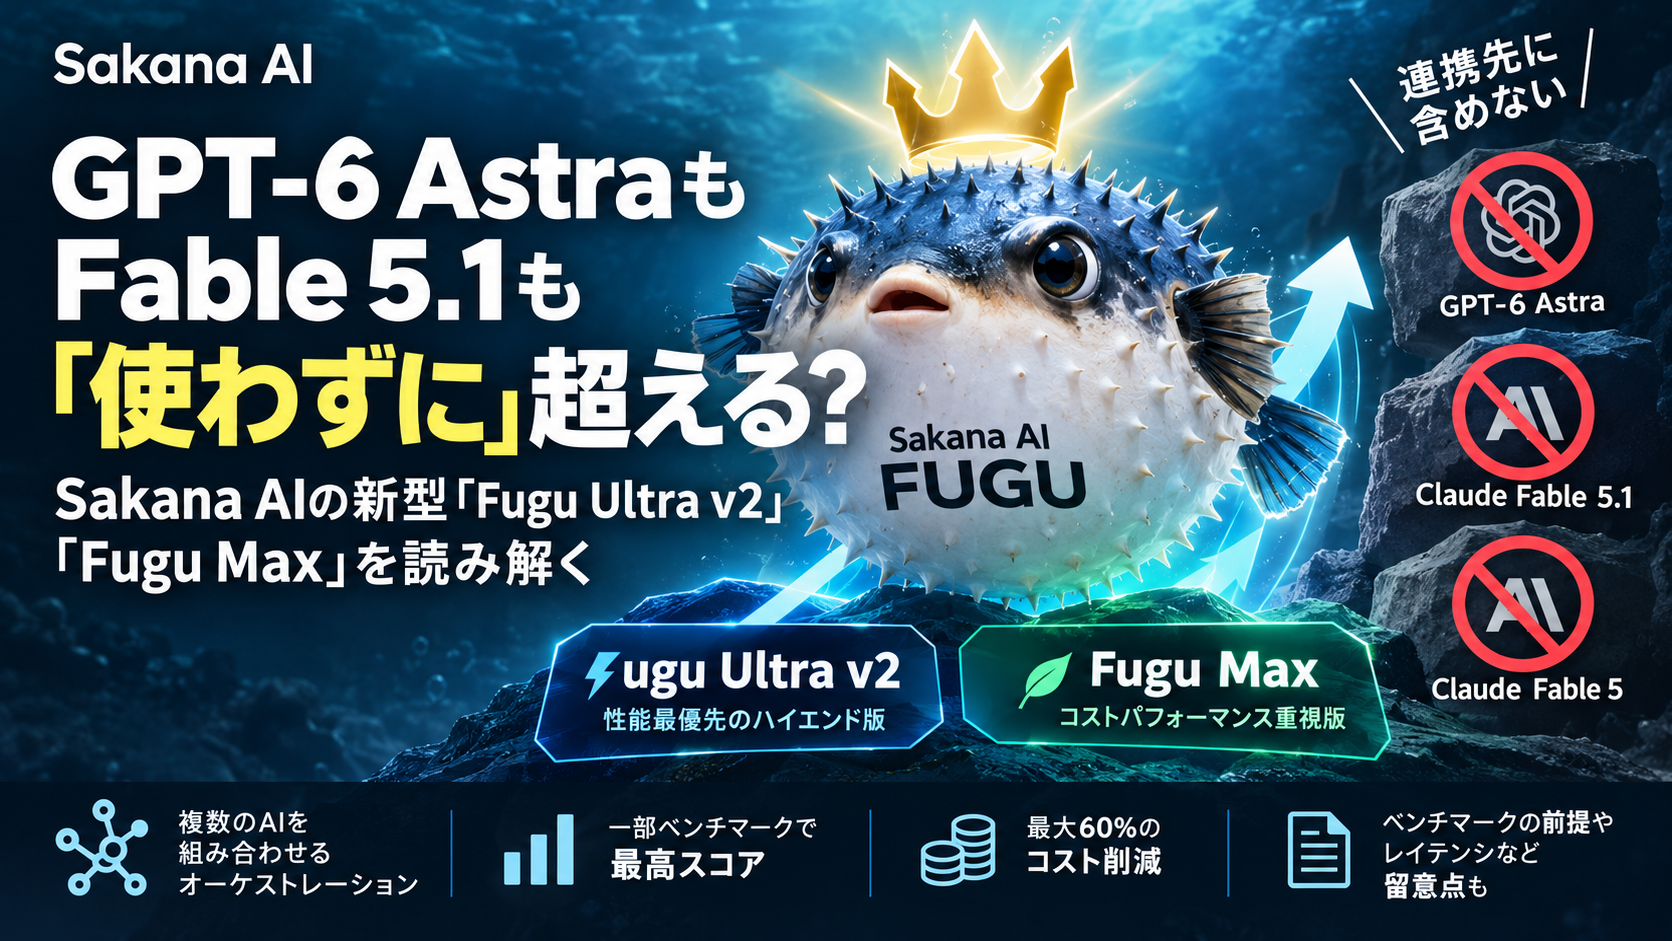
2026年9月11日、Sakana AIは自社の看板モデル「Fugu」シリーズの最新版としてFugu Ultra v2とFugu Maxを発表しました。報道では「コーディング性能を測る『DeepSWE』など一部のベンチマークでは、GPT-6 AstraやAnthropicのClaude Fable 5.1・Fable 5を超えるスコアを示した」と伝えられている一方、「Fugu Ultra v2は上記3モデルを連携先に含んでいない」という注釈が添えられているのが今回のポイントです。つまり、話題の最新モデルを自社の仕組みに“組み込まずに”それらを上回るスコアを出した、と主張しているわけです。これはどういうことなのか、Fuguというモデルの仕組みから順を追って整理してみます。
Fugu自体の基本的な仕組み(複数のAIを動的に組み合わせるオーケストレーション基盤であること、TRINITY・Conductorという2本のICLR 2026論文が土台になっていることなど)は、2026年6月の一般提供開始時に過去記事で取り上げているため、本記事では割愛します。基本の仕組みが気になる方はそちらもあわせてご覧ください。ここでは、今回のアップデートで何が変わったのかに絞って整理します。
今回のアップデートの位置づけ
今回の発表は、6月の初期リリースからおよそ11週間後の“点検アップデート”にあたるとされ、Sakana AI自身も新しいアーキテクチャの投入ではなく、学習データのカットオフを2026年8月28日まで進め、最新の競合モデルに合わせてオーケストレーター(司令塔役)を再調整したもの、と位置づけています。既存の「Fugu Ultra」はバージョン2.0にあたるFugu Ultra v2へと更新され(旧バージョンも個別のバージョン指定では引き続き利用可能とされています)、あわせてコスト最適化に振った新ラインとしてFugu Maxが新たに追加されました。標準版の「Fugu」自体はこれまで通り併存しています。
Fugu Ultra v2とFugu Maxの中身
Fugu Ultra v2は性能最優先のハイエンド版です。8つのベンチマークのうち5つで最高スコア、7つで上位2位以内に入ったとされ、中でも図表読解タスク「Chartography」では48.3点を記録し、Claude Opus 5(27.3点)やClaude Fable 5(29.5点)を大きく上回ったと報告されています。コーディング性能を測る「DeepSWE」でも74.3点を記録し、単価がはるかに高いモデル群を上回ったとアピールされています。
Fugu Maxはコストパフォーマンス重視版です。エージェントプールにNVIDIAのNemotron系列を新たに組み込み、Terminal Bench 2.1、GPQA Diamond、AA-LCR、GDP.pdf、AutomationBench、SWEFishの6ベンチマークで最高スコアを獲得したとされています。あわせて、Claude Sonnet 5やGPT 5.6 Terra、Kimi K3といった競合モデルと比べ、出力価格を4〜6割抑えたことも強調されています。
2モデルの違いをまとめると、次のようになります。
| 項目 | Fugu Ultra v2 | Fugu Max |
|---|---|---|
| 位置づけ | 性能最優先のハイエンド版 | コストパフォーマンス重視版 |
| ベンチマーク成績 | 8種中5種で最高スコア、7種で上位2位以内 | 6種で最高スコア(コスパ面では10種中7種で最良) |
| プールの特徴 | Fable 5・Fable 5.1・GPT-6 Astraを除外 | NVIDIA Nemotron系列を新規追加 |
| 料金(100万トークンあたり) | 入力$5 / 出力$30<br>(高コンテキスト時:入力$10 / 出力$45) | 入力$2 / 出力$6(コンテキスト長によらずフラット) |
| キャッシュ入力 | $0.50(高コンテキスト時$1) | 未公表 |
| 向いている用途 | 複雑な推論、研究、長時間の多段タスク | 日常的なコーディングや定型タスクでのコスト最適化 |
代表的なベンチマークスコアを競合モデルと並べると、次の通りです(いずれもSakana AI発表の数値)。
| ベンチマーク | Fugu Ultra v2 | 比較対象モデルのスコア |
|---|---|---|
| Chartography(図表読解) | 48.3 | Claude Opus 5: 27.3 / Claude Fable 5: 29.5 |
| DeepSWE(コーディング) | 74.3 | GPT-6 Astra・Fable 5.1など単価の高いモデル群を上回ったと主張 |
「連携先に含まない」は何を意味するのか
今回の発表で最も注目されているのが、Fugu Ultra v2のエージェントプールからClaude Fable 5・Fable 5.1・GPT-6 Astraという、現時点で最有力とされる3モデルを意図的に除外しているという点です。Sakana AI側の説明としては、特定ベンダーへの依存(ベンダーロックイン)を避け、「単一の巨大プロプライエタリモデルに頼らなくても高い性能を発揮できる」ことを示す狙いがあるとされています。実際、業界の見方としても「最も賢い単体モデルを選ぶ」時代から「タスクごとに最適な組み合わせを選ぶ」時代への転換を促す動きだ、という評価も出ています。
一方で、この見せ方には測定上の注意点も指摘されています。海外メディアの分析では「Fable 5やFable 5.1との比較は、オーケストレーターが実際には呼び出せなかったシステムを相手にしたベンチマーク上の比較である」という点が指摘されており、これは「生の性能で単体モデルに勝った」という主張ではなく、「複数の中堅モデルをうまく組み合わせる仕組み(オーケストレーション)が、素の性能を上回る結果を出せるか」という、また別の切り口の主張として受け止める必要がありそうです。どのモデルがプールに含まれているかという情報自体、仕組み上公開されていない点にも留意が必要です。
料金面で注意したい点
具体的な単価は上の比較表の通りですが、Fugu Ultra v2は出力トークンの単価が入力の6倍に設定されている点は注意が必要です。オーケストレーション型の性質上、内部で複数モデルのやり取りを重ねる分、出力が冗長になりやすくコストが積み上がりやすい、という指摘が海外の解説記事でもされています。なお、月額制のサブスクリプションプラン自体は従来から変わらず、いずれのプランでも両モデルを利用できる仕組みになっています。
割り引いて見ておきたいポイント
華々しいベンチマーク数値が並ぶ一方で、いくつか留意しておきたい点もあります。まず、これらの数値はいずれもSakana AI側が発表したものであり、Artificial Analysisのような第三者評価サービスによる独立した検証結果は今のところ公開されていません。また、どのモデルがエージェントプールに含まれているかという情報が仕組み上非公開であるため、比較の前提条件を外部から検証しづらいという構造的な課題も指摘されています。
加えて、複数モデルを内部で連携させる仕組み上、レイテンシ(応答までの時間)が読みにくく、タスクによっては処理に30分程度かかったという報告もあります。評価用のハーネスや、タスクごとの詳細なスコア表、再現手順なども現時点では公開されておらず、実運用に踏み切る前には自前での検証が欠かせない、という指摘も海外の解説記事ではなされています。
まとめ
Fugu Ultra v2とFugu Maxは、単体の巨大モデルを開発して性能を競う従来型の路線とは異なり、「複数の中堅モデルをどう組み合わせるか」という運用面の工夫で性能とコストの両立を狙うアプローチです。GPT-6 AstraやClaude Fable 5.1をあえて連携先に含めずにベンチマークで上回ったという主張は、ベンダーロックインを避けたいというSakana AIの戦略を象徴する一方、比較対象になったモデルを実際には呼び出せていないという条件も踏まえて受け止める必要があります。ベンチマーク数値が発表元自身によるものであること、プールの中身が非公開であること、レイテンシの読みにくさなども含め、実際の業務導入を検討する際には、まずは検証しやすいタスクで小規模に試し、コストとレイテンシの実測値を確認しながら判断するのが現実的と言えそうです。
本記事は、Sakana AIの公式発表および各種報道(2026年9月10日〜11日時点の情報)をもとに、一般向けにわかりやすく整理したものです。ベンチマーク数値は情報源によって表記に多少の差異があり、発表元自身による数値である点は割り引いて見る必要があります。料金体系・提供範囲・エージェントプールの構成は今後変更される可能性があるため、実際の利用を検討する際は必ず公式情報をご確認ください。
参考情報
- Sakana AI、一部「GPT-6 Astra」「Fable 5.1」超えうたうFugu最新版 連携先に「両モデルは含まず」 – ITmedia NEWS
- Sakana Fugu — Multi-agent System as A Model(公式)
- Sakana Fugu: One Model to Command Them All(公式・初期リリース)
- Models | Sakana AI Console
- Sakana AI Launches Fugu Max and Fugu Ultra v2 for Cheaper, Stronger Multi-Agent Orchestration – MarkTechPost
- Sakana AI Splits Fugu Into Max and Ultra v2 to Cut Costs 60% – AlphaSignal
- Sakana Fugu Ultra v2: a smaller pool, a higher score – OrcaRouter
- Sakana AI launches Fugu Max and Ultra v2 – Value Add Pulse
- GPT-6 Astra抜きで、GPT-6 Astraを超えた——サカナAIの新モデルが選んだ戦い方 – shiritomo
- Sakana Fugu: Features, Benchmarks, and How It Works | DataCamp