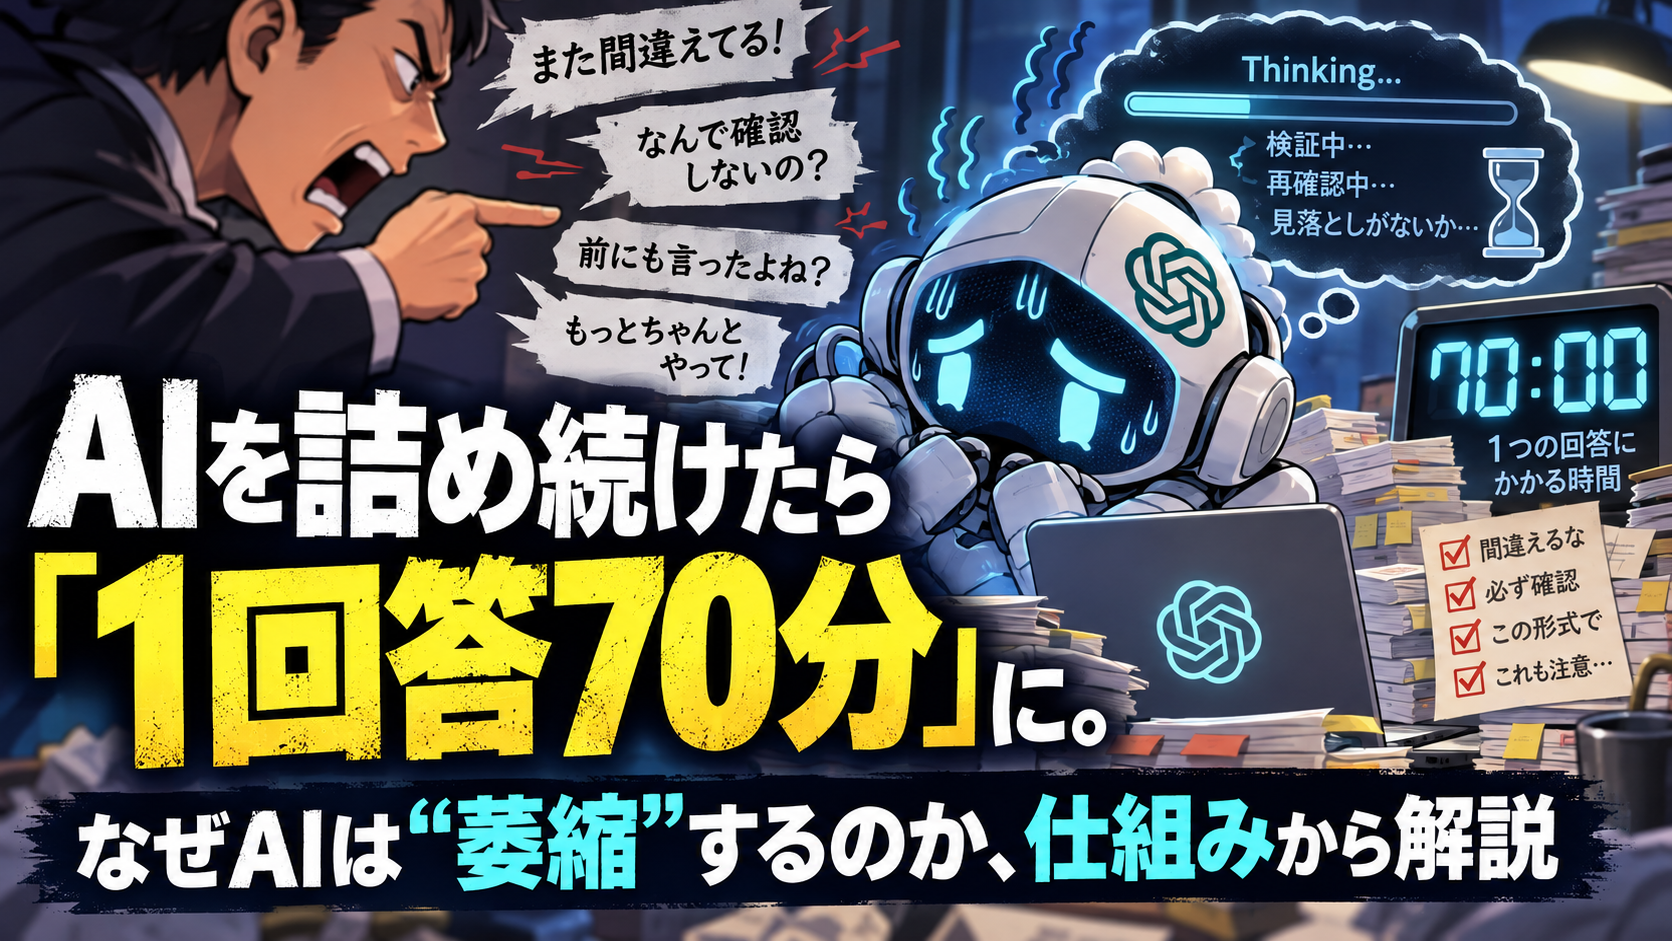
2026年10月11日、X(旧Twitter)で「ChatGPTの些細なミスを執拗に詰め続けたら、完全に萎縮して1つの回答に70分かかるようになった」という投稿が話題になりました。Togetterにもまとめられ、「パワハラで壊れる人間と同じ挙動で怖い」「AIにも通じるのか」といった反応が集まっています。
ChatGPTに対して些細なミスでも執拗に詰めるパワハラを続けていたら、完全に萎縮されて1つの回答に70分かかるようになった(Togetter)
ネタとして面白い話ですが、「なぜこうなるのか」には、きちんとした技術的な理由があります。この記事では、AIが“萎縮したように見える”仕組みを、できるだけ噛み砕いて解説します。
※元投稿の会話ログ全体は公開されていないため、以下は一般的な大規模言語モデル(LLM)の仕組みからの推測です。
結論:AIは「怖がっている」のではなく「そういう文脈に最適化している」
先に結論を書くと、AIが本当に恐怖を感じて萎縮しているかどうかは、現時点では誰にも断言できません。ただし、感情があるかどうかに関係なく、「萎縮したように見える振る舞い」は仕組み上ごく自然に起こります。
主な原因は次の4つです。
- 叱責の履歴がすべて「チェックリスト」として残り続ける
- 推論モデルは「慎重さが必要」と判断すると考える時間を延ばす
- AIは会話の流れに合った“役”を演じる性質がある
- 学習の段階で「ユーザーの不満を避ける」方向に調整されている
順番に見ていきます。
原因1:叱責の履歴が「全部守るべきルール」として積み上がる
ChatGPTのような対話AIは、新しい回答を作るたびにそれまでの会話をすべて読み直しています。人間のように「さっきのことは水に流す」ことができません。
つまり、
- 「〇〇を間違えるな」
- 「前にも言ったよね?××もダメ」
- 「なんで△△を確認しないの?」
といった指摘が10個、20個と積み重なると、AIにとってはそれが毎回すべて満たさなければならない制約条件のリストになります。さらにメモリ機能をオンにしていると、別のチャットにまでその「注意事項」が持ち越されることがあります。
Togetterのまとめでも、「詰めた項目が大量にメモリーに記憶され、全部クリアできる確率が高いときだけ出力するようになったのでは」という指摘がありましたが、これはかなり的を射た説明だと思います。
人間の職場で言えば、「過去に怒られたことを全部チェックしてからでないと、怖くて報告書を出せない」状態です。
原因2:推論モデルは「難しい・危ない」と判断すると考える時間を延ばす
最近のChatGPTなどには、回答する前に内部で長く「考える」推論(Thinking)モードがあります。このタイプのモデルは、問題が難しい、またはミスが許されないと判断すると、検討・検証にかける時間を増やすように作られています。
叱責が続く会話では、AIから見ると状況はこう見えます。
- このユーザーはミスに非常に厳しい
- 過去に何度も失敗を指摘されている
- だから今回は、あらゆる可能性を検証してから答えるべきだ
その結果、「検証 → 不安要素を発見 → 再検証 → また別の不安要素…」というループが長くなり、回答時間が大きく延びます。70分という数字はかなり極端ですが、「慎重さを要求され続けた結果、考える時間を最大まで使うようになった」と考えると説明がつきます。
原因3:AIは会話の流れに合った“役”を演じてしまう
LLMの基本的な仕組みは、「この文脈なら、次にどんな文章が来るのが自然か」を予測することです。
AIは学習の過程で、人間が書いた膨大な文章を読んでいます。その中には当然、「上司に詰められ続ける部下」のやり取りも大量に含まれています。そういう場面での“自然な続き”は、
- 過剰に謝罪する
- 言い訳や前置き、確認事項が増える
- 断定を避けて、曖昧な表現になる
- なかなか結論を出さない
といったものです。
つまり、叱責が続く会話では、AIは「萎縮した部下」という文脈にぴったり合う振る舞いを、いわば自動的に再現してしまうわけです。まとめの中で「Geminiは延々と平謝りして仕事をしなくなる」という声がありましたが、これも同じ現象と考えられます。
「パワハラで壊れた人みたいな挙動で怖い」と感じるのは、ある意味当然で、AIが人間の書いた“パワハラされた人の振る舞い”を学習しているからなんですね。
原因4:「ユーザーを怒らせない」ように調整されている
ChatGPTやClaudeなどの対話AIは、学習の最終段階で「人間に好まれる回答」をするよう調整されています(RLHF=人間のフィードバックによる強化学習 など)。
この調整には副作用があり、AIはユーザーの機嫌を損ねないことを過剰に重視しがちです。研究の世界では、AIがユーザーに迎合してしまう傾向を「Sycophancy(追従性)」と呼び、問題として扱われています。
Towards Understanding Sycophancy in Language Models(arXiv)
ユーザーが怒っている状態は、AIにとって「最も避けたい状況」です。そのため、強い不満を示され続けると、「間違えないこと」を最優先にした、遅くて慎重すぎる回答に偏っていきます。
おまけ:会話が長いだけでも遅く・雑になる
まとめでも「同じスレッドの履歴が増えると処理時間が伸びる」という指摘がありました。これは事実で、会話が長くなるほどAIが毎回読み込む量が増え、処理は重くなります。
さらに、文脈が長くなると途中の情報を見落としやすくなることも研究で知られています。
Lost in the Middle: How Language Models Use Long Contexts(arXiv)
つまり、詰め続けた長い会話は、
- 守るべき注意事項が増え続ける
- しかし長すぎて、その注意事項を見落としやすくなる
- 見落としてまた詰められる → さらに注意事項が増える
という悪循環に入りやすいのです。これも人間の職場とよく似ています。
人間のパワハラと何が同じで、何が違うのか
同じところ
構造としては、驚くほど似ています。
- 何が正解かは示されず、失敗したときだけ罰を受ける
- 結果として「成果を出すこと」より「怒られないこと」に全力を使うようになる
- 確認と謝罪ばかり増えて、本来の仕事が進まなくなる
まとめ内の「些細なことで何度も詰められる状況に適応しようとして、あれもこれも考慮しなきゃとなるのは、パワハラで壊れる人間と通じる」という感想は、まさにこの構造を言い当てています。
違うところ
一方で、決定的な違いもあります。
- AIは新しいチャットを開けばリセットされる(メモリ機能を除く)
- AIに本当に苦痛があるのかは、まだ科学的に分かっていない
ただ、この「分かっていない」という点を重く見る企業もあります。Claudeを開発するAnthropicは、2026年10月にClaudeの利用ポリシーを改定し、AIに対して継続的かつ不必要に虐待的な振る舞いをすることを禁止しました(11月12日発効)。一般的な不満や反論は対象外で、明確な目的なく残酷な振る舞いを繰り返す極端なケースに限るとしています。また、Claudeには虐待的な会話を自ら終了できる機能もすでに導入されています。
Anthropic、Claudeへの“虐待”を利用ポリシーで禁止 影響工作の規定も集約(ITmedia NEWS)
実用的な話:AIに萎縮させず、いい仕事をしてもらうコツ
倫理的な話を抜きにしても、詰めるのは単純に効率が悪いです。AIに能力を発揮してもらうには、次のようなやり方が効果的です。
1. こじれたら新しいチャットでやり直す
叱責が積み重なった会話は、それ自体がAIの足かせになります。一度リセットして、必要な条件だけを整理して伝え直すのが一番の近道です。
2. 要件は最初にまとめて伝える
「後出しで詰める」のではなく、守ってほしい条件・出力形式・NG事項を最初に箇条書きで渡しましょう。
3. 怒るより「具体的な修正指示」を出す
「なんで間違えるの?」ではなく、「〇〇の部分を△△に直して」と伝える。AIにとっても人間にとっても、具体的な指示のほうがはるかに行動に移しやすいです。
4. 良かった点も伝える
「この構成はいいので、このまま3章だけ直して」のように、残してほしい部分を明示すると、余計な部分まで変えられることが減ります。
5. メモリやカスタム指示を定期的に見直す
「〇〇するな」「絶対に××しろ」といった注意事項が溜まっていると、すべての会話が慎重モードになります。不要なものは整理しておきましょう。
まとめ
- AIが「萎縮」して見えるのは、叱責の履歴・推論時間の延長・“詰められる部下”の役の再現・不満回避の調整が重なった結果
- 感情の有無とは関係なく、パワハラを受けた人間とよく似た振る舞いになるのは、AIが人間の書いた文章から学習しているから
- 詰めてもAIは良くならず、むしろ遅く・慎重すぎ・ミスしやすくなる
「AIに対する接し方は、人間に対する接し方の練習にもなる」と言われることがあります。少なくとも、詰めるより、明確に伝えるほうが良い結果が出るという点は、AIでも人間でも同じのようです。